
Como eu uso IA: o que funciona pra mim
No último final de semana, fiz uma viagem de carro pela Flórida para assistir ao lançamento do telescópio Roman em Cabo Canaveral. Enquanto dirigia, fui conversando com o Hermano, um agente de IA que instalei no meu servidor caseiro. O agente rodava em um computador no Brasil; eu estava no meio da Flórida, mandando áudios do meu carro. Mesmo assim, consegui trabalhar com ele em uma quantidade surpreendente de tarefas: desenvolvimento de automações, manutenções diversas do meu servidor.
Embora essas tarefas sejam relevantes apenas para quem passou muitos anos acumulando gadgets e hardware como entusiasta de tecnologia, vejo elas como um proxy para a habilidade cada vez maior dos computadores usarem eles mesmos. Não a toa que parte central da mensagem de marketing do anúncio do GPT-6 essa semana foi que “Anything you can do on a computer, Astra can do for you. Fast.”.
A IA tomou conta de uma parte significativa da atenção de todos desde o final de 2022. Para mim, aumentou vertiginosamente em 2026 depois que, na sequência do “boom” do Claude Code no final do ano passado, o David, CEO do Nubank, anunciou que estávamos all-in em IA. A partir dali, com o privilégio de ter acesso essencialmente ilimitado aos modelos mais capazes, incorporei a IA em todas as superfícies digitais da minha vida. Experiências recentes como essa na estrada e outras me fizeram sentir na pele a magia (a palavra é essa mesmo) da “fronteira”; mas para isso, apenas ter acesso aos modelos não é suficiente, eu também precisei que as peças ao redor deles funcionassem bem juntas.
A ideia desse texto é compartilhar minha experiência e o que tem funcionado pra mim, pensando que pode ser útil para outras pessoas com diferentes níveis de familiaridade com IA. Eu não me considero um especialista, apenas alguém que investiu muitas horas interagindo com os modelos nos últimos anos. Tenho certeza que aplicando essas recomendações simples você verá um aumento exponencial no retorno obtido com os modelos.
1. Use Markdown para sua base soberana
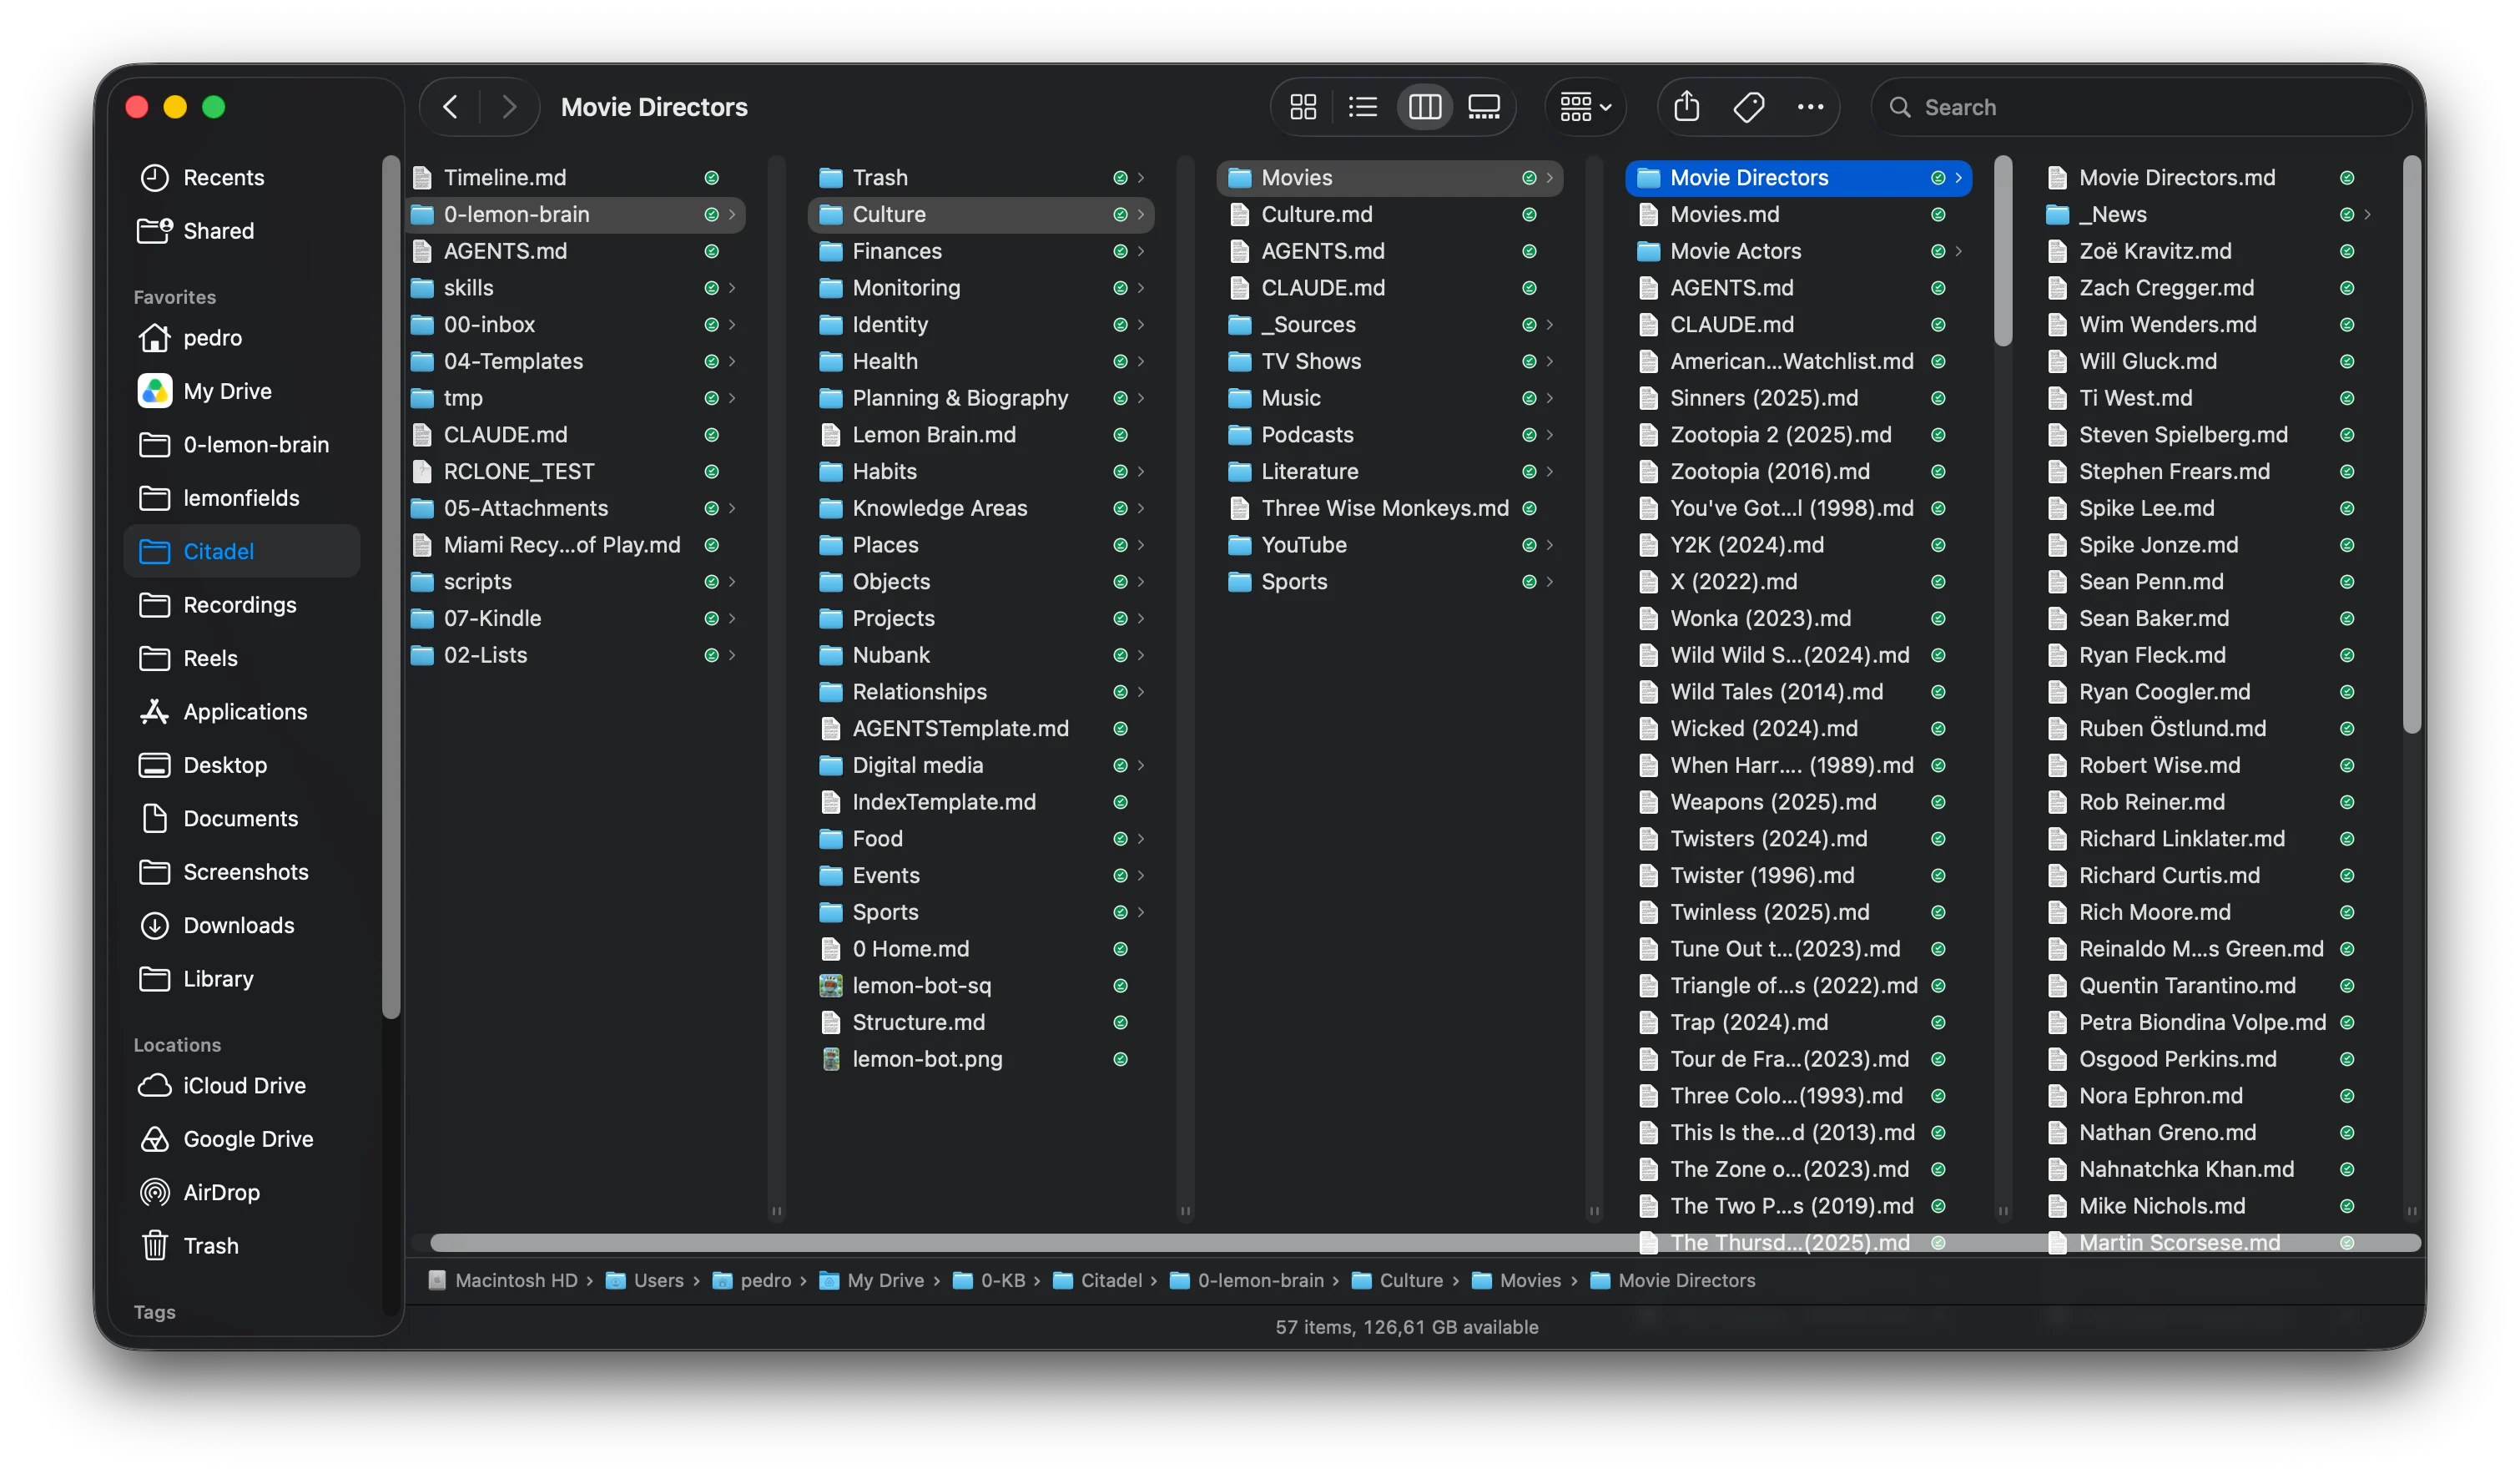
A primeira peça é ter uma base de conhecimento em arquivos Markdown.
Markdown é um formato leve de texto que aceita uma sintaxe básica de formatação, como cabeçalhos, negrito e bullet points. Você pode abrir esses arquivos em diferentes programas. Eu uso o Obsidian, mas o aplicativo é menos importante do que o princípio: os arquivos ficam numa pasta que você controla, e as ferramentas de IA trabalham sempre nessa pasta.
Isso parece um detalhe técnico, mas muda a relação com a ferramenta. Estamos tão acostumados com Google Docs, Office 365 e aplicativos na nuvem que até o conceito de guardar arquivos numa pasta local parece antigo. Para mim, ele voltou a ser central.
A pasta me garante que o contexto é meu. Eu não fico preso ao aplicativo da OpenAI, da Anthropic ou do Google. Posso trocar de modelo e continuar apontando a nova ferramenta para os mesmos arquivos. Essa flexibilidade importa porque a qualidade relativa dos modelos muda muito rápido. Em um trimestre, Gemini parece melhor. Depois, Claude. Agora, ChatGPT.
No longo prazo, o valor maior está nessa curadoria feita por você. Os modelos vão continuar melhorando. Se eu cultivar os meus próprios arquivos, organizados e com backup, cada geração futura de modelos poderá trabalhar sobre um contexto melhor do que a anterior. O investimento não fica preso ao histórico de um chat ou de um fabricante específico. Ele se acumula numa base que eu levo comigo.
Eu mantenho uma base pessoal e outra profissional. Essa separação existe por confidencialidade. Tirando esse limite, tento evitar fragmentar o contexto em vários lugares. Essa concentração traz riscos, então exige backup e regras claras de acesso, mas ainda é a melhor forma que encontrei de fazer a IA entregar valor hiper personalizado ao meu contexto com o mínimo de esforço.
Para sincronizar esses arquivos entre dispositivos, uso o Google Drive e o Obsidian Sync. Prefiro esse caminho como camada principal da minha base pessoal porque ele é menos técnico, aceita arquivos binários como planilhas e permite abrir alguns formatos diretamente no Google Docs. No celular, uso o Obsidian para fácil acesso aos arquivos Markdown.
2. Deixe rastros para a IA seguir
A segunda peça é deixar rastros (“breadcrumbs”) para a IA.
Uma sessão nova não carrega, naturalmente, a bagagem da sessão anterior. Alguns produtos já oferecem ferramentas de memória, mas elas não substituem um contexto completo, confiável e portátil. Sem instruções cultivadas por você, a ferramenta começa sabendo muito pouco sobre quem você é, o que está fazendo, quais objetivos importam e como prefere trabalhar.
Por isso, as instruções carregadas no início de cada sessão têm um efeito transversal na qualidade das respostas. Elas evitam que eu precise repetir as mesmas explicações, preferências, definições e ajudam o modelo a entrar mais rápido no assunto certo com o mínimo de esforço.
Eu organizo essas instruções por domínio. Planejar uma viagem requer preferências sobre atividades, comida, deslocamento e formato do itinerário. Manter um servidor caseiro exige documentação, arquitetura, comandos, regras de segurança. O agente não precisa carregar todas as preferências de viagem quando está fazendo manutenção no meu servidor.
Na prática, uso um arquivo AGENTS.md como fonte principal. O nome varia conforme a ferramenta: Codex reconhece AGENTS.md, Claude Code usa CLAUDE.md e Gemini CLI usa GEMINI.md. Eu escolhi AGENTS.md como arquivo canônico e uso arquivos pequenos direcionando pra ele para assegurar compatibilidade com os outros.
Nesse arquivo principal, que fica na raiz da pasta, entram coisas como a estrutura da base, regras para usar conectores, informações básicas sobre o ambiente e a obrigação de carregar instruções mais específicas quando o trabalho entra em determinado domínio. É esse arquivo principal que vai ser carregado em todo o início de uma nova sessão e vai direcionar o modelo para os outros dentro de cada subdiretório.
Ressalto que a qualidade dessas instruções importa muito, para o bem e para o mal. Uma instrução boa melhora todas as sessões futuras. Uma instrução ruim também prejudica todas elas. Já vi o agente seguir caminhos completamente errados porque uma regra estava mal escrita ou desatualizada. A curadoria desse arquivo AGENTS.md significa tanto adicionar o que falta quanto remover o que deixou de ser verdade. Vale também a máxima de que “menos é mais”.
Alguns exemplos das regras mais importantes que eu uso e você pode usar como semente para plantar a sua própria base de conhecimento:
- This is Pedro's personal knowledge base, called **PKB**. It covers every **personal** domain of his life, each containing a folder with an index and specific instructions to that domain.
- **The vision:** durable, model-portable markdown context about Pedro's life that (a) any current or future AI can consume directly, (b) powers background routines that improve his life, and (c) feeds itself from his digital footprint (receipts, voice memos, transcripts). Prefer plain markdown + frontmatter over anything tool-specific.
- For every user query—before answering, acting, or starting web research—first identify the potentially relevant domain(s), read the root and nearest domain `AGENTS.md`, then search for and read relevant notes, principles, roles, owned products, plans, people, places, habits, or prior research. This applies even when the request sounds casual. If the knowledge base has no relevant context, proceed with the appropriate external/live tools; never substitute stale facts for live system or current-world checks.
3. Use conectores para informações em tempo real e tomada de ações
Enquanto os arquivos da base de conhecimento guardam contexto durável e histórico, os conectores trazem o contexto atualizado.
No Nubank, isso significa dar ao modelo acesso aos sistemas em que o trabalho realmente acontece: Google Workspace, Slack, Jira e Confluence. Na vida pessoal, significa acesso aos serviços do Google, Home Assistant, n8n e outros sistemas que opero.
A diferença é muito grande. Sem os conectores, o modelo pode explicar como fazer alguma coisa. Com conectores, ele pode encontrar o documento certo, consultar o estado real, executar uma ação e verificar o resultado.
Os conectores também precisam aparecer no AGENTS.md, com rastros claros de quais usar, quando usar, para garantir que vão ser usados. Eu mantenho uma regra que identifica quais conectores são obrigatórios para cada tipo de tarefa. Se um deles estiver indisponível, o agente deve parar em vez de improvisar uma resposta com informação incompleta. É uma proteção muito eficaz contra alucinação e trabalho desperdiçado, dado que muitas vezes simplesmente não faz sentido continuar sem o conector.
Novamente, a instrução só funciona se estiver atualizada. Se ela exigir uma conexão que não existe mais, o agente vai parar sem necessidade. Esse é outro exemplo de como a curadoria das instruções pode melhorar ou piorar todo o sistema.
4. O aplicativo que você usa para interagir com o modelo precisa dos seus arquivos locais
Também importa muito qual aplicativo você usa para conversar com o modelo e colocar essas peças em funcionamento. Em inglês, esse tipo de aplicativo costuma ser chamado de agent harness. Em português, fico com o “aplicativo”: o software que reúne modelo, arquivos, instruções, ferramentas, permissões e conectores numa mesma experiência.
Os modelos melhoram e mudam o tempo inteiro, então valorizo uma ferramenta que me permita trocar rapidamente entre eles e testar qual funciona melhor para cada tarefa. O acesso ao sistema de arquivos também é central. Quero apontar a ferramenta para o diretório persistente da minha base de conhecimento, trabalhar com arquivos diferentes e revisar o que ela propõe antes de aprovar um conjunto de ações.
No trabalho, tenho usado o Cursor. Claude Code também é muito bom, mas o Cursor tem sido mais amigável no cotidiano por reunir uma interface gráfica agradável, acesso aos arquivos e escolha de modelos. Costumo manter de três a cinco sessões em paralelo, dependendo da tarefa e do momento do dia, e consigo mover texto entre elas com facilidade. Ainda assim, não trato essa escolha como permanente. A disponibilidade dos modelos muda, e ferramentas como Codex também melhoraram bastante.
As empresas de IA ainda explicam mal a diferença entre o modo de “chat” e o modo de “trabalho” dos próprios produtos. Para mim, a principal diferença está no acesso persistente a uma pasta com a minha base de conhecimento e instruções. Os conectores também importam, mas hoje eles aparecem em ambas. O que muda de verdade é a capacidade de operar sobre os arquivos que acumulam o contexto e localmente sem depender de um conector para edições mais substanciais.
Na vida pessoal, tenho usado cada vez mais o Hermes Agent. A diferença é que converso com ele por um aplicativo de mensagens, o Discord, porque as threads me permitem separar as sessões que rodam em paralelo, como eu faria no Slack ou no Microsoft Teams. O Discord virou a superfície de contato com o texto e com as conclusões produzidas a partir dos meus arquivos.
Isso também mudou meu uso do Obsidian no celular. Ainda abro o aplicativo quando preciso consultar uma fonte, mas consulto menos as notas diretamente. Muitas vezes faço a pergunta ao Hermano e recebo pelo chat a síntese baseada no contexto armazenado nos arquivos Markdown. O setup do Hermano e do meu servidor caseiro merece um texto próprio; aqui, o ponto é só mostrar por que a camada de execução importa.
5. Fale com o modelo; use e abuse da sua voz
A peça final que eu recomendo muito usar e abusar é a voz. A qualidade do reconhecimento de fala e da transcrição deu um salto enorme nos últimos anos. O efeito prático é simples: falar permite tirar mais contexto da cabeça, com menos esforço, do que parar para escrever cada prompt. Eu penso nisso como um brain dump. Em vez de tentar organizar tudo antes, começo a falar e deixo as ideias saírem na ordem em que aparecem.
Faço isso sempre que posso, principalmente quando estou sozinho. Posso ditar para o celular, gravar um áudio numa ferramenta de mensagens ou falar diretamente com o aplicativo. Este próprio texto começou assim: eu o ditei para o meu relógio (!), depois editei no computador.
A transcrição ficou muito melhor, mas ainda não é perfeita. Por isso, aviso nas instruções AGENTS.md que uso voz e que o texto pode conter erros de transcrição. O modelo pode corrigir o que for inequívoco e perguntar quando ficar na dúvida.
O brain dump também não precisa sair organizado. Quanto mais eu falo, mais percebo que um mesmo áudio contém várias tarefas. Uma ideia puxa outra, surgem ajustes e aparecem caminhos que eu não teria percebido se tentasse escrever um prompt perfeito de primeira. Tudo fica registrado, e depois posso separar esses caminhos com o modelo.
Mas o modelo não é o mais importante?
Há uma ausência proposital nesta lista: o modelo em si. Eu poderia dizer qual é o meu preferido hoje, mas essa recomendação ficaria desatualizada em poucas semanas. Novas versões aparecem o tempo inteiro, e a liderança muda rápido entre as empresas.
A ideia é que esse texto seja (um pouco) mais durável do que uma comparação de modelos publicada em setembro de 2026. Para acompanhar capacidade e benchmarks, uso o Artificial Analysis. O que quis retratar aqui são as escolhas que continuam úteis quando o modelo muda: arquivos próprios em Markdown, instruções bem cuidadas, conectores para suas ferramentas, ser tagarela com seu computador e um aplicativo que orquestre bem as quatro coisas.
Quer comentar este texto?
A mensagem é privada. Nome e e-mail são opcionais; inclua seu e-mail somente se quiser uma resposta.